team-bootstrap — фреймворк доставки для ШІ
Open-source рольовий фреймворк доставки для Claude Code: шар proof-of-delivery над spec-driven development, з пайплайнами, незалежним верифікатором і гардрейлами на хуках.
- Роль
- Автор і мейнтейнер
- Стек
- Claude CodeShellOpenTelemetryMCPSpec Kit
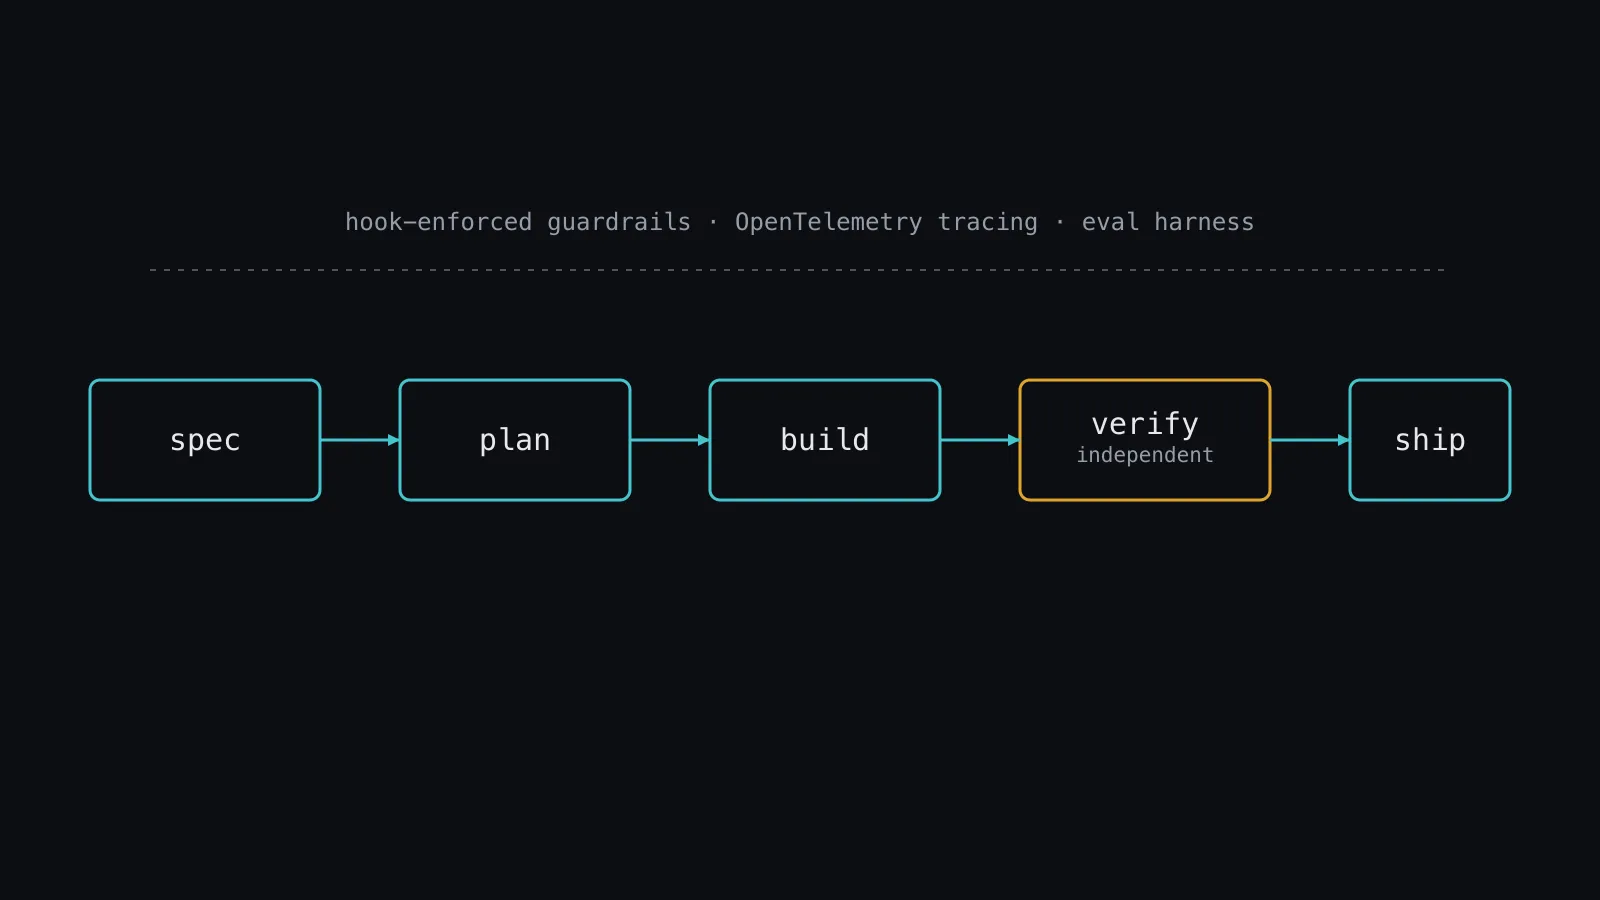
team-bootstrap — мій open-source фреймворк, щоб кодувальні агенти доставляли надійно, а не ad hoc. Він проводить інженерну задачу через ролі Product, Architecture, Implementation, Review і Release усередині Claude Code — зі структурованими передачами, валідацією та спостережністю.
Код: github.com/polischuks/team-bootstrap · MIT · v4.
Що це, точно
Інструменти spec-driven development (SDD) ведуть ідею до коду й на цьому зупиняються — GitHub Spec Kit прямо каже, що продукує артефакти й не перевіряє, чи реалізація задовольняє специфікацію. team-bootstrap — це та відсутня половина: шар proof-of-delivery над SDD. Його предмет — верифікація на момент закриття: які ролі заробила зміна, чи справді вони працювали як незалежні уми, і чи можна вважати партію завершеною. Pre-implementation потік він запускає через власні команди Spec Kit, а не замінює їх.
Це свідомо не харнес. Харнес — це Claude Code; team-bootstrap — шар політики над ним, і тому кожен потрібний важіль запитується через hook API хоста, а не проситься в прозі.
Дизайн
За замовчуванням він single-thread: ролі — це output-стилі, активовані для окремих фаз однієї сесії Claude, що ділять run-документ як дошку. Сабагенти запускаються лише для ізоляції контексту — дослідження, аудит безпеки, паралельні рев’ю — і ніколи для делегування рішення. Це відповідає принципу Cognition «Don’t Build Multi-Agents»: ділись контекстом широко, сабагентами — вузько. Багаторольові пайплайни лишаються для роботи, що потребує формальних гейтів і аудит-сліду.
Дизайн закріплений версіонованою конституцією інваріантів (P1–P12), які поважає кожен мілстоун — серед них: політика на харнесі з LLM поза контуром безпеки (P3), незворотність за гейтом підтвердження (P5), типізовані схемо-валідовані передачі (P4), верифікація доказом red→green, а не твердженням (P9), і верифікація, що кумулятивна й fail-closed (P10).
Пайплайни запуску
Задача підбирається до пайплайна, а не ганяється через універсальну оркестрацію:
| Пайплайн | Що виконується | Коли |
|---|---|---|
single-thread |
одна сесія, три фази: plan → implement → verify | більшість інженерних задач (дефолт) |
mvp |
7 ролей: product-ba → delivery-manager → cto-architect → backend → frontend → qa → release-docs | внутрішнє, низький ризик, швидкі ітерації |
full |
20 ролей: + discovery, формальний product/business/test design, спеціалізовані рев’юери, product- і growth-маркетинг (GTM), release manager, комунікація зі стейкхолдерами й документація | продакшн, customer-facing, чутливе до комплаєнсу |
role |
одна цільова роль за назвою | коли потрібна лише одна фаза |
audit |
15 ролей, read-only | технічна/операційна готовність → беклог виправлень |
l2p |
6 ролей, з дисципліною доказів | розриви landing↔platform↔docs → ICE-ранжований беклог |
audit-dd |
6 ролей due-diligence, read-only | інвестиції / M&A / борд → інвесторська пам’ятка |
Go-to-market змодельований як ролі, а не окремий пайплайн: product-marketer (ICP, позиціонування, прайсинг, launch-sequencing), growth-marketer (канали, контент-движок, AI-search posture) і partnerships-lead вбудовуються у full — і доступні в single-thread — за тригером «новий продукт / новий ICP / репозиціонування / зміна прайсингу / новий GTM-motion».
/deliver зшиває все в один вхід для spec-driven мілстоуна. Фаза A виконується автономно — constitution → specify → clarify → plan → tasks → analyze — і зупиняється на жорсткому блокері чи CRITICAL-неузгодженості. Фаза B розбиває задачі на партії й запускає їх по одній через обраний пайплайн, чекаючи підтвердження між партіями; сабагенти комітять локально, і нічого не пушиться без явного дозволу. Без заданого тіру він сам визначає розмір запуску, читаючи tasks.md/plan.md для рольового плану на кожен потік робіт. Перервані запуски resume з останньої завершеної передачі; replay з трасування — для eval-ів на регресію промптів.
Як перевіряється доставка
Довіра — від застосування, а не від прози. Політику несуть 46 fail-closed скриптів-перевірок і хуки Claude Code (PreToolUse, Stop/SubagentStop, SessionStart, UserPromptSubmit, PreCompact) — тож правило застосовує хост, а не надія, що агент його пам’ятає. Передачі між ролями типізовані й схемо-валідовані; незалежний рев’юер, верифікатор інтеграції та regression guardian перевіряють роботу, а не «збирач сам оцінює себе». Кожен запуск трасується OpenTelemetry, а eval-harness вимірює, чи справді зміна у фреймворку покращує доставку.
Run-документ
Кожен запуск продукує єдиний markdown run-документ: метадані запуску, секція на кожну роль із виходом і YAML-передачею, і фінальний вердикт — рішення про реліз або список блокерів. Це канонічний аудит-запис і вхід для оцінювальних eval-ів. «Заблоковано» завжди краще за хибне «готово».